サーベイで分かるのは「どこに問題があるか」です。「なぜ起きたか」「来週、何を変えるか」までは、点数からは出てきません。
毎週測るかどうかではありません。測るだけで終わるのか、本人が動くところまで行くのかです。
毎週10分、AIが本人に問い返します。何が起きたか、なぜそうなったか、来週は何を一つ変えるか。測るのではなく、本人が動くところまでを残します。誰が言ったかは、上には上げません。
週1回10分。いまのサーベイも評価シートも、そのまま。1部署・数名から始められます。
まず壁打ちを1回試す→サンプルレポートが開く→相談する
社員アンケートは毎年やっているが施策につながっていないと感じている人事・経営者の方へ。
最後まで進むと、下のほうにある実際のレポート(サンプル)が開きます。
制度を入れ替える話ではありません。いまの評価シートと等級のまま、評価の前後に「考える時間」を足します。
ふつうの評価システムは③評価するが中心です。EvaliAは、①目標を自分で決め、②毎週の壁打ちで進め、③評価するまでを一つにつなぎます。
点数を上げることを、目的にしていません。点数は成績ではなく、原因を探すための手がかりです。上げるために測るのではなく、次の行動を変えるために測ります。
AIは点数を一切つけません。問いを返すだけです。
出典:東京コンサルティンググループ「数字で見るTCG」(2025年12月時点)
3つ以上当てはまったら、調査の設計ではなく、間隔の問題です。
思い当たるものをタップしてください。
点数は出ています。出ていないのは、そうなった出来事です。
足りないのは調査の精度ではありません。点数になる手前の出来事が、どこにも残っていないことです。

人が黙るのが先で、点数が下がるのは何か月も後です。分かったころには、その人はもう動いています。
「上司に相談できなかった」は5段階のどこにも入りません。数字になった時点で、手がかりが落ちています。
調査は目的ではなく、いまの状態を知らせる合図です。合図を良く見せても、現場は変わりません。
このまま放置すると、起こり得ること(よくある悪循環)
まず壁打ちを1回試す→サンプルレポートが開く→相談する
本人・評価者・経営。同じ問いかけが、3つの相手に効きます。
① 社員が育つ ② 評価者が育つ ③ 経営が見える。
説明ではなく、実際の画面でお見せします。
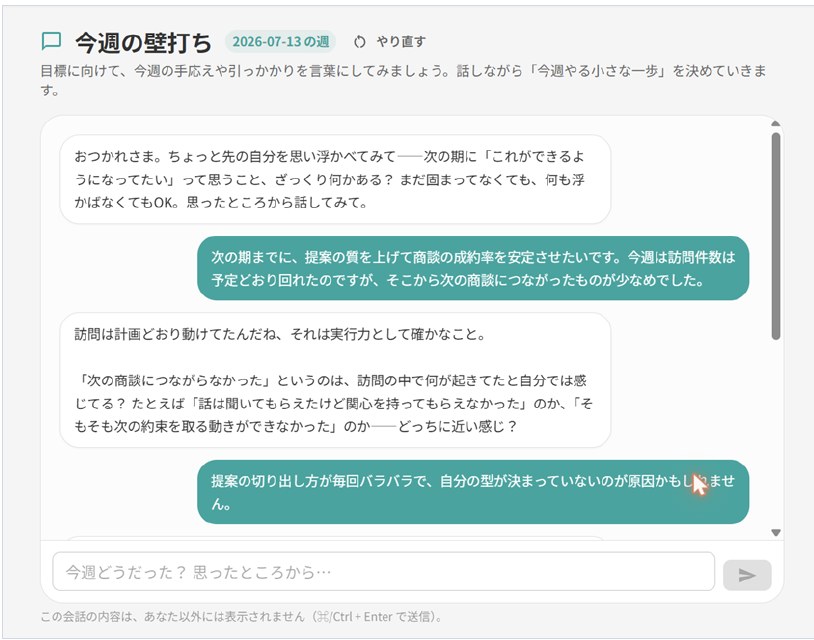
毎週5〜10分の壁打ちです。答えは配りません。話しているうちに、本人が自分で原因にたどり着きます。下は実際の画面の対話です。
※ 実際の画面です。対話内容はデモ用に差し替えています。
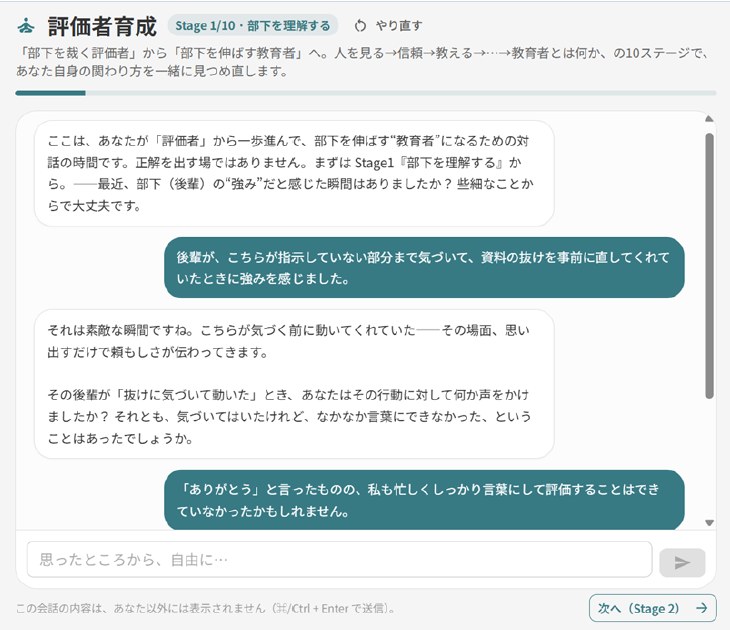
「部下を裁く評価者」から「部下を伸ばす教育者」へ。評価をつけるその場でAIが根拠を尋ね、反対の事実がないかも一緒に探します。研修ではなく、日々の関わり方を問い直す対話です。段階を追って進みます(画面は最初の段階)。
※ 実際の画面です。対話内容はデモ用に差し替えています。
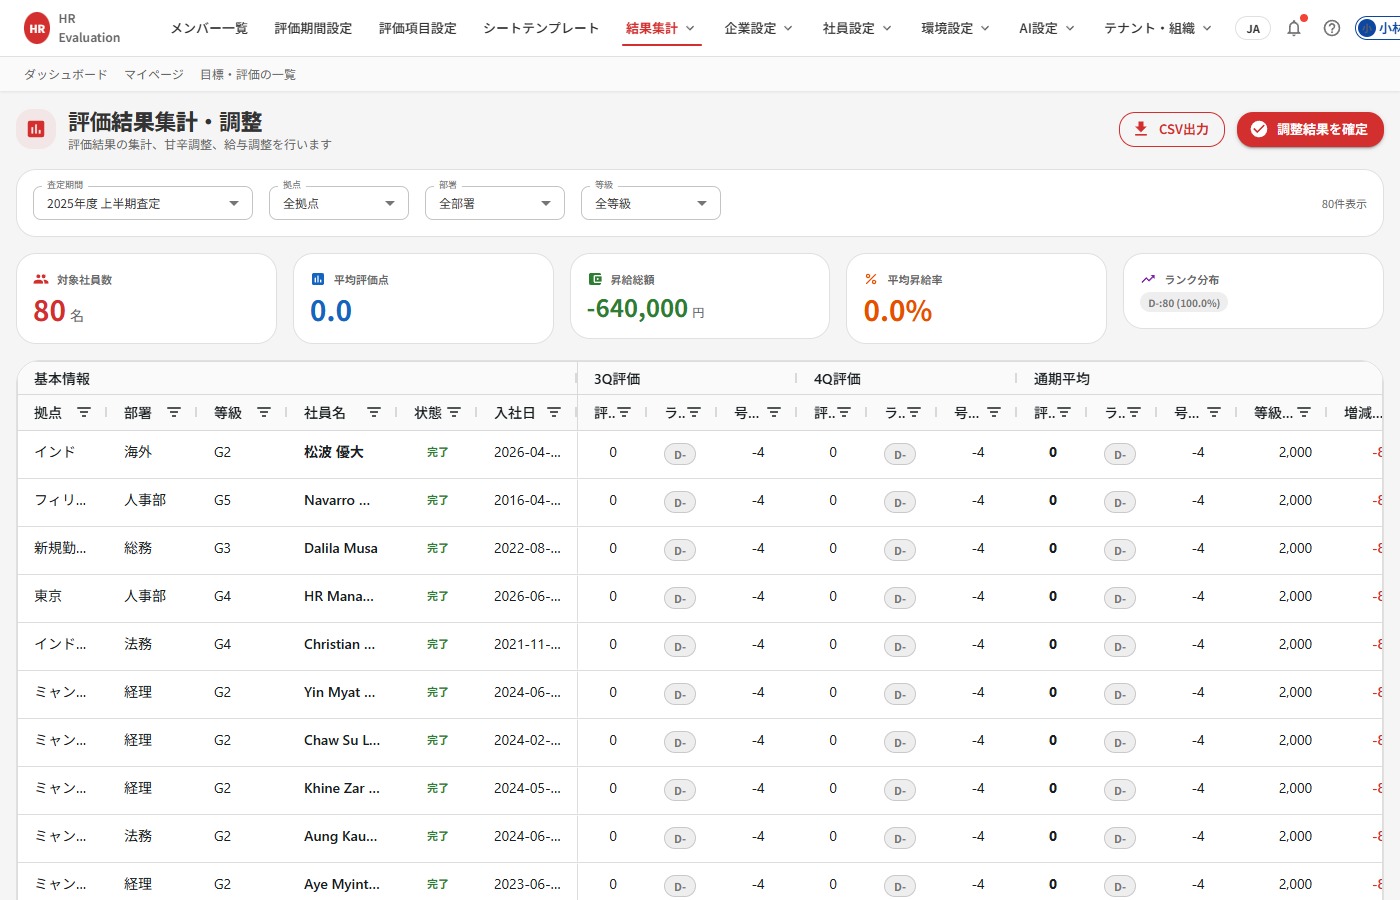
拠点・部署・等級をまたいで、全社員を同じ基準で1枚に見渡せます。海外拠点も同じ表に並びます。誰をどこに置くか、誰にどう関わるかを、印象ではなく分布で決められます。
※ 実際の画面です。氏名・数値はデモ用に差し替えています。
サーベイは、状態を測ります。EvaliAは、そのあいだの出来事を残します。
評価システムと比べる話ではありません。評価と評価のあいだの半年に、何も置かれていないという話です。
※ 左列は、多くの評価システムが重視している点をまとめたものです。特定の製品を指すものではありません。どちらかを選ぶ話ではなく、いまお使いのものに足す話です。
個人の目標と会社の目標が重なる点をAIが問い、「決めさせられた目標」ではなく「自分で決めた目標」にします。
毎週の壁打ちで、詰まった理由を本人の言葉にし、翌週の一歩を決めます。対話そのものは、上司にも見えません。上司に届くのは、AIが整理した「進んでいる/止まっている」の合図だけです。
目標・評価シート、10ステップの承認、集計。多くの評価システムが重視するのは、ここです。
EvaliAは③に①②を足しています。査定ではなく、行動が変わることを目的にしているからです。
そのために投げる問いは、私たちが1問ずつ設計しています(評価する側に100問、される側に500問)。
2週間で、短く答えて終わる人が8名から3名になりました。
2026年9月、当社グループ日本本社70名・2週間の結果を、プレスリリースとして公開しました。
社外の事例ではなく、まず自分たちで使った実測です。
| 日本本社70名の会話の型 | 1週目 | 2週目 |
|---|---|---|
| 週次コーチングを実施した人 | 48名 | 54名 |
| 短く答えて終わる | 8名 | 3名 |
| 自分から材料や数字を出して会話を動かす | 17名 | 20名 |
出典:東京コンサルティンググループ プレスリリース「『AIと週10分話す』と、社員の行動は変わるのか」(2026年9月10日)
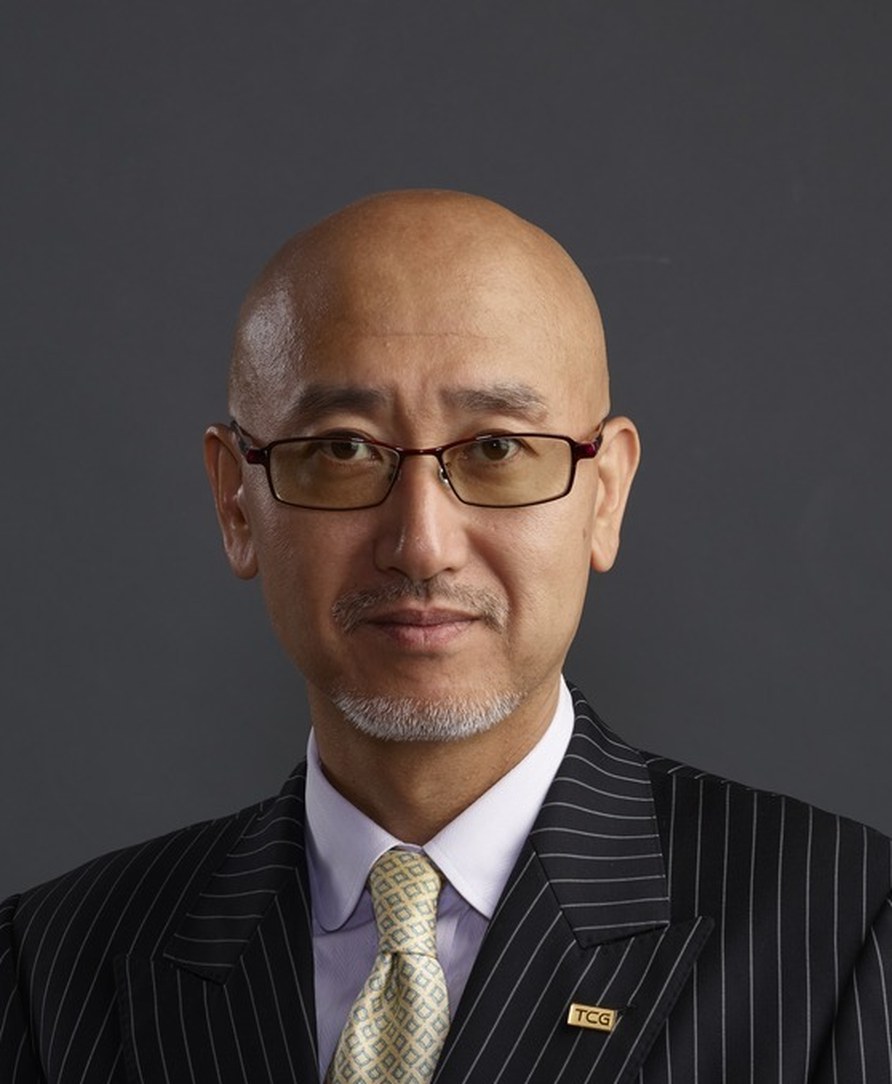
「評価制度に20年取り組んできて分かったのは、人に序列をつけても人は育たないということでした。必要なのは、本人が自分で考えて動けるようになることです。ただ、上司が毎週一人ひとりと向き合う時間は現実には取れません。そこをAIに担わせています。AIは答えを出す役ではなく、本人が自分の言葉にするまで問い返す役です。決めるのも動くのも人です」
東京コンサルティンググループ
取締役会長 久野康成(プレスリリースより)
費用の基準は、月5万円・初期10万円。50アカウントまで込み、追加は1アカウント1,000円(すべて税抜)。規模に合わせて、ご相談のうえ決めます。料金の詳細を見る
対話は、この5つの観点で振り返ります。人を判定するための観点ではなく、本人が翌週の一歩を決めるための観点です。
ページ最上部の「今週の壁打ち」を最後まで進めると、
ここに実際のレポート(サンプル)が開きます。約2分です。
壁打ちおつかれさまでした。これが、毎週の会話からできあがるレポートです(クリックすると、このページ内で拡大します)。
※ 当社グループ日本本社の実データを匿名化したサンプルです。社員名は「社員NN」、社名・顧客名は置き換えています。クリックすると、このページ内で拡大します。
導入いただくと、御社の会話から同じ形式のレポートをお作りします。
まず壁打ちを1回試す→サンプルレポートが開く→相談する
EvaliA 1本だけで始められます。あとから他とつながります。
会社・顧客・社員をめぐる循環の中で、社員への人事を担う部分です。必要になった領域から、段階的に広げられます。
向いていない使い方もあります。先に書いておきます。
迷う場合は、まずご相談ください。合わない場合は、その旨を率直にお伝えします。
いまのサーベイも評価シートも、そのままで構いません。
いまのサーベイは、やめなくて構いません。年1回の調査はそのまま続けられます。
足すのは、その間を埋める週1回10分だけです。いきなり全社ではなく、1部署・数名から始められます。
入力は6項目だけ(会社名・お名前・メール・電話番号・役職・従業員規模)。翌営業日までに、担当からご相談の日程をご連絡します。
サーベイの設問、実施時期、拠点の分け方。作り替えずに、どこに週1回を置くかを一緒に決めます。
参加する方のアカウントを発行します。最初に15問のかんたん診断に答えていただきます。
上のデモと同じ流れで、詰まりと翌週の一歩を自分の言葉にします。積み上がった会話から、拠点分析レポートと会話品質レポートができます。
合わないと感じたら、その旨を率直にお伝えします。しつこい営業はいたしません。
下の金額が基準です。規模に合わせて、ご相談のうえ決めます。
これは基準の金額です。人数・拠点数・いまの制度に合わせて、ご相談のうえ決めます。
いきなり全社ではなく、1部署・数名から始められます。
表示はすべて税抜です(税込:初月165,000円/以降 月額55,000円)。
EvaliAの金額は、規模に合わせてご相談のうえ決めます。SCAD全体の料金は 料金ページ をご覧ください。
いちばん多いのは「誰が言ったか上に伝わるのか」です。伝えません。
まず、このページの壁打ちを1回やってみてください。
その先の話は、それからで構いません。1部署・数名から始められます。
まず壁打ちを1回試す→サンプルレポートが開く→相談する
入力は3分。翌営業日までに、メールかお電話でご連絡します。
1部署・数名からで大丈夫です。しつこい営業はいたしません。
お急ぎの場合は 03-5369-2930(平日 9:00〜18:00)へ。